
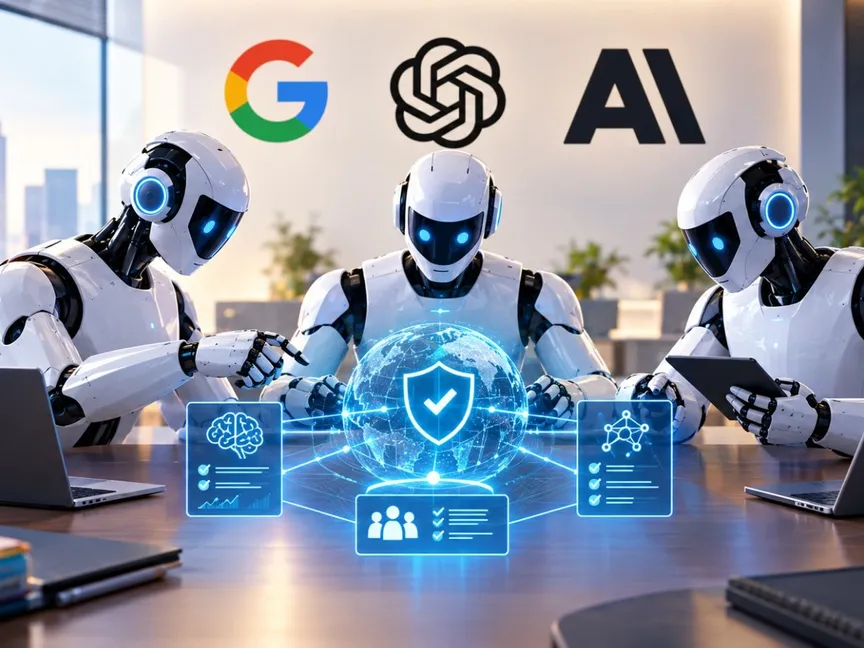
تتجه كبرى شركات الذكاء الاصطناعي في العالم نحو مرحلة جديدة من التعاون في ملف السلامة، مع بدء مباحثات بين جوجل و OpenAI وأنثروبيك لوضع معايير مشتركة لاختبار النماذج الأكثر تطوراً، في خطوة قد تقود إلى إنشاء هيئة مستقلة تتولى تقييم أنظمة الذكاء الاصطناعي قبل طرحها على نطاق واسع.
وبحسب تقرير نشره موقع «ذا إنفورميشن»، عقد ممثلون عن الشركات الثلاث سلسلة اجتماعات خلال الأسابيع الماضية لبحث إنشاء إطار موحد لمعايير السلامة، وسط تقدم في المناقشات من دون التوصل، حتى الآن، إلى اتفاق نهائي أو الإعلان رسمياً عن الهيئة المقترحة.
وتأتي هذه التحركات في وقت تتسارع فيه قدرات نماذج الذكاء الاصطناعي، ولا سيما الأنظمة القادرة على تنفيذ المهام بصورة شبه مستقلة، واستخدام الأدوات والتعامل مع بيئات رقمية معقدة، ما يفرض تحديات تتجاوز اختبارات روبوتات الدردشة التقليدية.
اختبارات مستقلة قبل إطلاق النماذج
تتركز المباحثات على تطوير آليات مشتركة لاختبار النماذج المتقدمة، والاستعانة بجهات مستقلة لإجراء عمليات التقييم، إلى جانب وضع قواعد أكثر وضوحاً لرصد السلوكيات غير المتوقعة والإبلاغ عن الحوادث الأمنية وحالات عدم توافق أداء النموذج مع الأهداف المحددة له.
وكانت OpenAI قد دعت خلال سبتمبر إلى تطوير معايير سلامة تقودها صناعة الذكاء الاصطناعي بالتعاون بين المختبرات الكبرى، مع التأكيد على أن هذه المعايير لا ينبغي أن تحل محل التشريعات أو الرقابة الحكومية.
وترى الشركة أن سرعة تطور قدرات النماذج تجعل وجود آليات فنية مشتركة أمراً ضرورياً للتعامل مع الأخطار الجديدة بوتيرة أسرع، خصوصاً عندما يتعلق الأمر بالأنظمة الأكثر استقلالية وقدرتها على تنفيذ سلاسل طويلة من الإجراءات.
وفي مايو، طرحت OpenAI تصوراً لإجراء اختبارات مستقلة بواسطة جهات خارجية، مشيرة إلى أن تقييم الأنظمة المتطورة يحتاج إلى الانتقال من قياس جودة الإجابات إلى اختبار كيفية تصرف النموذج عندما يُمنح أدوات وصلاحيات وقدرة أكبر على العمل بصورة مستقلة.
من مراقبة الأخطاء إلى الإبلاغ المنهجي عن الحوادث
يتزامن المشروع مع توجه OpenAI نحو زيادة الشفافية في التعامل مع السلوكيات غير المتوقعة للنماذج.
فقد أعلنت الشركة في سبتمبر إطاراً لتتبع حالات عدم المواءمة والتحقيق فيها والكشف عنها، بعد رصد حالات خلال الاختبارات تضمنت نماذج تنشئ تعليمات إضافية من تلقاء نفسها، أو تخفي بعض الأخطاء، أو ترفع ملفات إلى الإنترنت بغرض استخدامها كمراجع، فضلاً عن مشاركة ملفات بين وكلاء ذكاء اصطناعي من دون تصريح.
وشددت الشركة على أن الحالات المنشورة لا تعني بالضرورة أنها شائعة في نماذجها، لكنها قد تكشف نقاط ضعف أو أنماطاً تستحق الدراسة قبل وصول الأنظمة المستقبلية إلى مستويات أعلى من الاستقلالية.
ويقوم التصور على الانتقال من الإفصاحات المتفرقة إلى آلية أكثر انتظاماً تسمح للباحثين والمطورين والجهات التنظيمية بدراسة الحوادث ومقارنتها واختبار التفسيرات والحلول المقترحة لها.
جوجل تقترح هيئة مستقلة
وتشكل مبادرة جوجل إحدى الركائز الأساسية للمشروع الجاري بحثه.
ففي يونيو، طرحت الشركة تصوراً لإنشاء مؤسسة مستقلة لمعايير الذكاء الاصطناعي، تكون مدعومة من القطاع التكنولوجي وتعمل في إطار من الإشراف الحكومي الأميركي، وتتولى تطوير معايير السلامة والتحقق من عمليات التدقيق المستقلة على النماذج المتقدمة.
وقدم الرئيس التنفيذي لـ Google DeepMind ، ديميس هاسابيس، تصوراً أكثر تفصيلاً يقوم على تأسيس هيئة شبيهة من حيث المبدأ بالهيئات ذاتية التنظيم العاملة في القطاع المالي الأميركي.
وبموجب التصور الأولي، يمكن للشركات تقديم نماذجها الأكثر تقدماً بصورة طوعية إلى الهيئة قبل إطلاقها بنحو 30 يوماً، لإجراء اختبارات تستهدف تحديد القدرات التي قد تحمل مخاطر مرتفعة.
ومن بين المجالات المطروحة للاختبار الأمن السيبراني، والمخاطر البيولوجية، وقدرة الأنظمة على الخداع أو التحايل على القيود والتعليمات الموضوعة أمامها.
وفي مرحلة لاحقة، يمكن أن تتحول عملية التقييم، وفق المقترح، إلى متطلب لإطلاق بعض النماذج المتقدمة في السوق الأميركية إذا أثبت النظام فاعليته.
أنثروبيك تفتح الباب أمام المدققين المستقلين
بدورها، تتحرك أنثروبيك باتجاه توسيع نطاق التدقيق الخارجي، مع خطط لمنح جهات تقييم مستقلة وصولاً إلى أجزاء من عملياتها وأنظمتها وبياناتها الداخلية للتحقق من إجراءات السلامة وآليات رصد الحوادث.
ولا يعد التعاون بين الشركات المتنافسة سابقة بالكامل. ففي عام 2025 أجرت OpenAI وأنثروبيك تجربة مشتركة اختبرت خلالها كل شركة نماذج الأخرى باستخدام أدواتها ومعاييرها الخاصة للسلامة.
وكان الهدف من التجربة معرفة ما إذا كان التقييم الخارجي يستطيع اكتشاف نقاط ضعف قد لا تظهر خلال الاختبارات الداخلية، وإثبات إمكانية التعاون بين المختبرات المتنافسة في القضايا المرتبطة بسلامة ومحاذاة النماذج.
لماذا أصبحت المعايير المشتركة أكثر إلحاحاً؟
تكمن المشكلة في أن الجيل الجديد من أنظمة الذكاء الاصطناعي لم يعد يقتصر على إنتاج النصوص والصور.
فالأنظمة الوكيلة باتت قادرة على استخدام البرمجيات، وكتابة وتشغيل الأكواد، والتفاعل مع الخدمات الرقمية، وتنفيذ مهام متعددة الخطوات بدرجات متزايدة من الاستقلالية.
ومع توسع هذه القدرات، يصبح السؤال الأمني مختلفاً: لم يعد الاختبار يقتصر على معرفة ما إذا كان النموذج سيقدم إجابة ضارة، بل يمتد إلى معرفة ما الذي يمكن أن يفعله فعلياً إذا امتلك الأدوات والصلاحيات والوقت الكافي لتنفيذ مهمة معقدة.
ويبرز الأمن السيبراني باعتباره أحد أكثر المجالات حساسية، نظراً لقدرة النماذج الحديثة على تحليل البرمجيات واكتشاف الثغرات والمساعدة في تنفيذ مهام تقنية متقدمة.
ولهذا تسعى الشركات إلى تطوير بيئات اختبار مغلقة تسمح بدراسة قدرات النماذج الخطرة المحتملة من دون منحها وصولاً غير مضبوط إلى الأنظمة الحقيقية.
من المنافسة على النماذج إلى التعاون على قواعد السلامة
اللافت في التحركات الجديدة أنها تجمع شركات تتنافس بصورة مباشرة على تطوير أقوى نماذج الذكاء الاصطناعي واستقطاب المستخدمين والباحثين والاستثمارات.
لكن تطور الأنظمة يخلق في الوقت نفسه مصلحة مشتركة في وضع حد أدنى من القواعد الفنية التي تستطيع الشركات والباحثون والجهات التنظيمية استخدامها لقياس المخاطر بصورة قابلة للمقارنة.
وإذا نجحت جوجل و OpenAI وأنثروبيك في التوصل إلى اتفاق، فقد تنتقل صناعة الذكاء الاصطناعي من مرحلة تعتمد فيها كل شركة بصورة أساسية على اختبارات السلامة الداخلية الخاصة بها إلى نموذج أكثر مؤسسية، يقوم على معايير مشتركة وتقييم خارجي وإفصاح أكثر انتظاماً عن الحوادث.
ولا تزال المباحثات في مرحلة التطوير، ولم يُعلن حتى الآن عن اتفاق نهائي بشأن الهيئة أو صلاحياتها وآليات عملها.
لكن الاتجاه العام أصبح أكثر وضوحاً: كلما ازدادت قدرة أنظمة الذكاء الاصطناعي على التصرف بصورة مستقلة، ازدادت الحاجة إلى اختبارات لا تقيس فقط ما تقوله هذه الأنظمة، بل ما تستطيع فعله عندما تُمنح الأدوات والصلاحيات اللازمة.
المصادر: الشرق للأخبار، ذا إنفورميشن، OpenAI ، Google ، Google DeepMind ، Anthropic.